近年來,Python 成為了最受歡迎的程式語言之一,特別是在網路爬蟲(Web Crawler)的應用領域。網路爬蟲技術可以自動化地從網路上抓取大量資料,對於資料分析、市場研究、學術研究等領域都非常有價值。本文將帶你深入了解網路爬蟲的基礎知識,並透過 Scrapy 框架提供一個完整的實戰範例。
什麼是網路爬蟲?
網路爬蟲,又稱為網路蜘蛛(Web Spider)或網路機器人(Web Robot),是一種自動化程式,它會依照預設的規則,系統性地瀏覽全球資訊網(WWW)並抓取其中的網頁內容。想像一下,它就像一隻勤奮的蜘蛛,在巨大的網路上爬行,收集所有它感興趣的資訊。
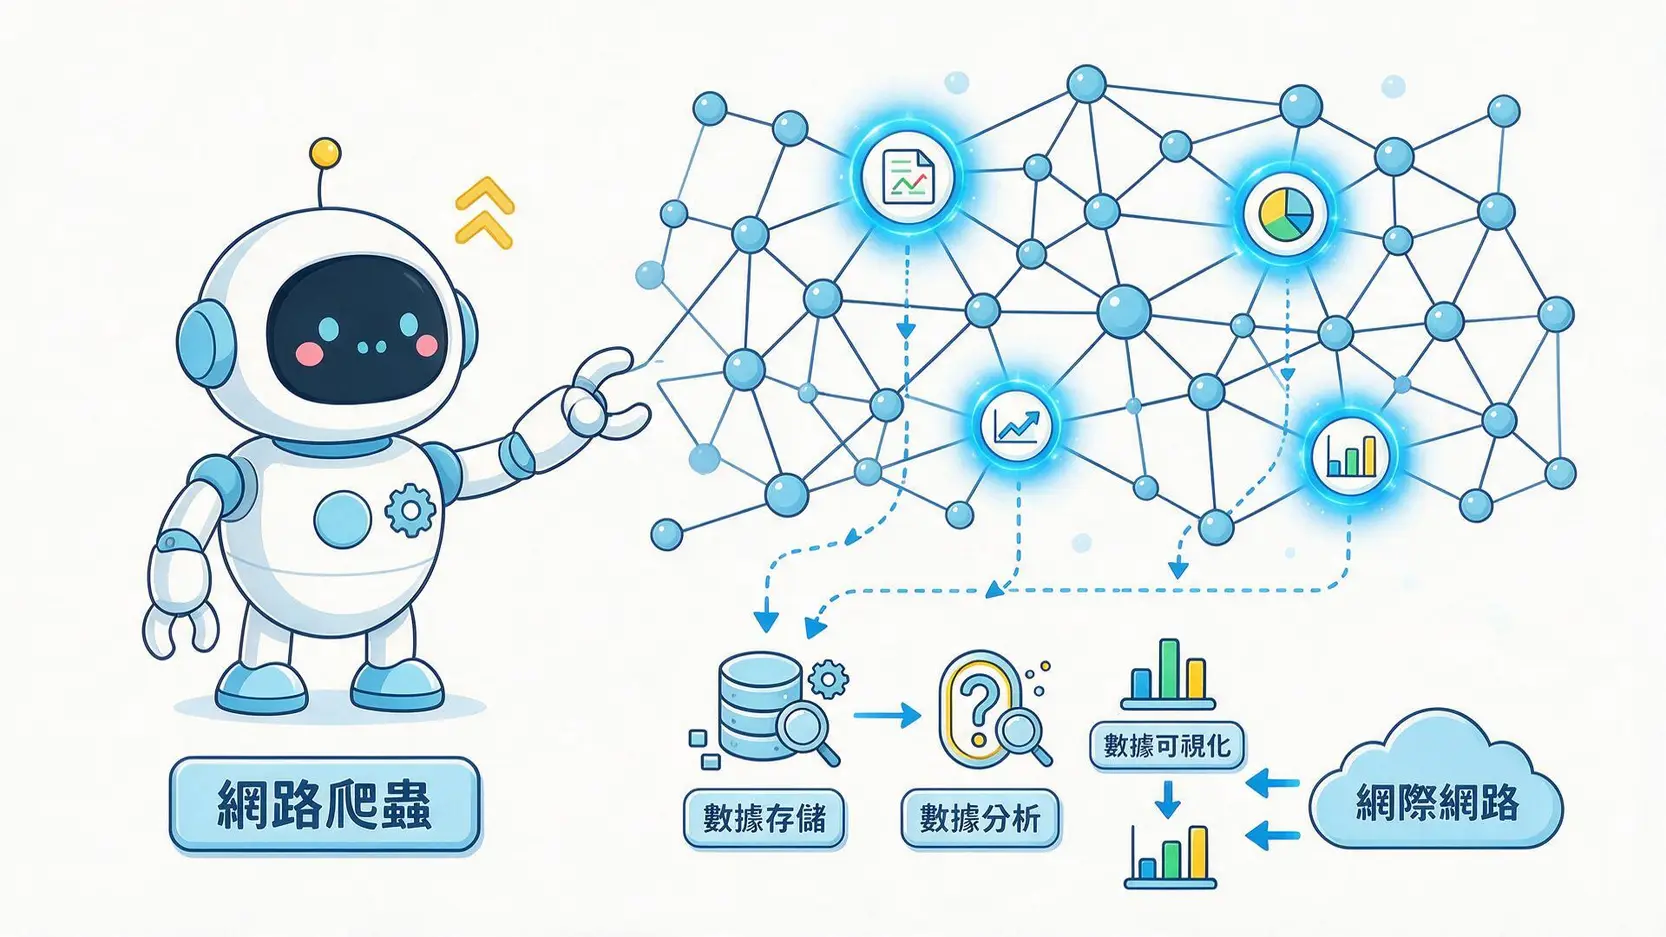
網路爬蟲的用途
網路爬蟲的應用非常廣泛,以下是一些常見的例子:
Python 網路爬蟲實戰:使用 Scrapy 抓取 PTT 八卦版文章
接下來,我們將進入實戰環節,使用 Python 的 Scrapy 框架來抓取 PTT 八卦版(Gossiping)的文章標題、作者、發布時間和連結。Scrapy 是一個功能強大且高效的爬蟲框架,非常適合處理大型的爬蟲專案。
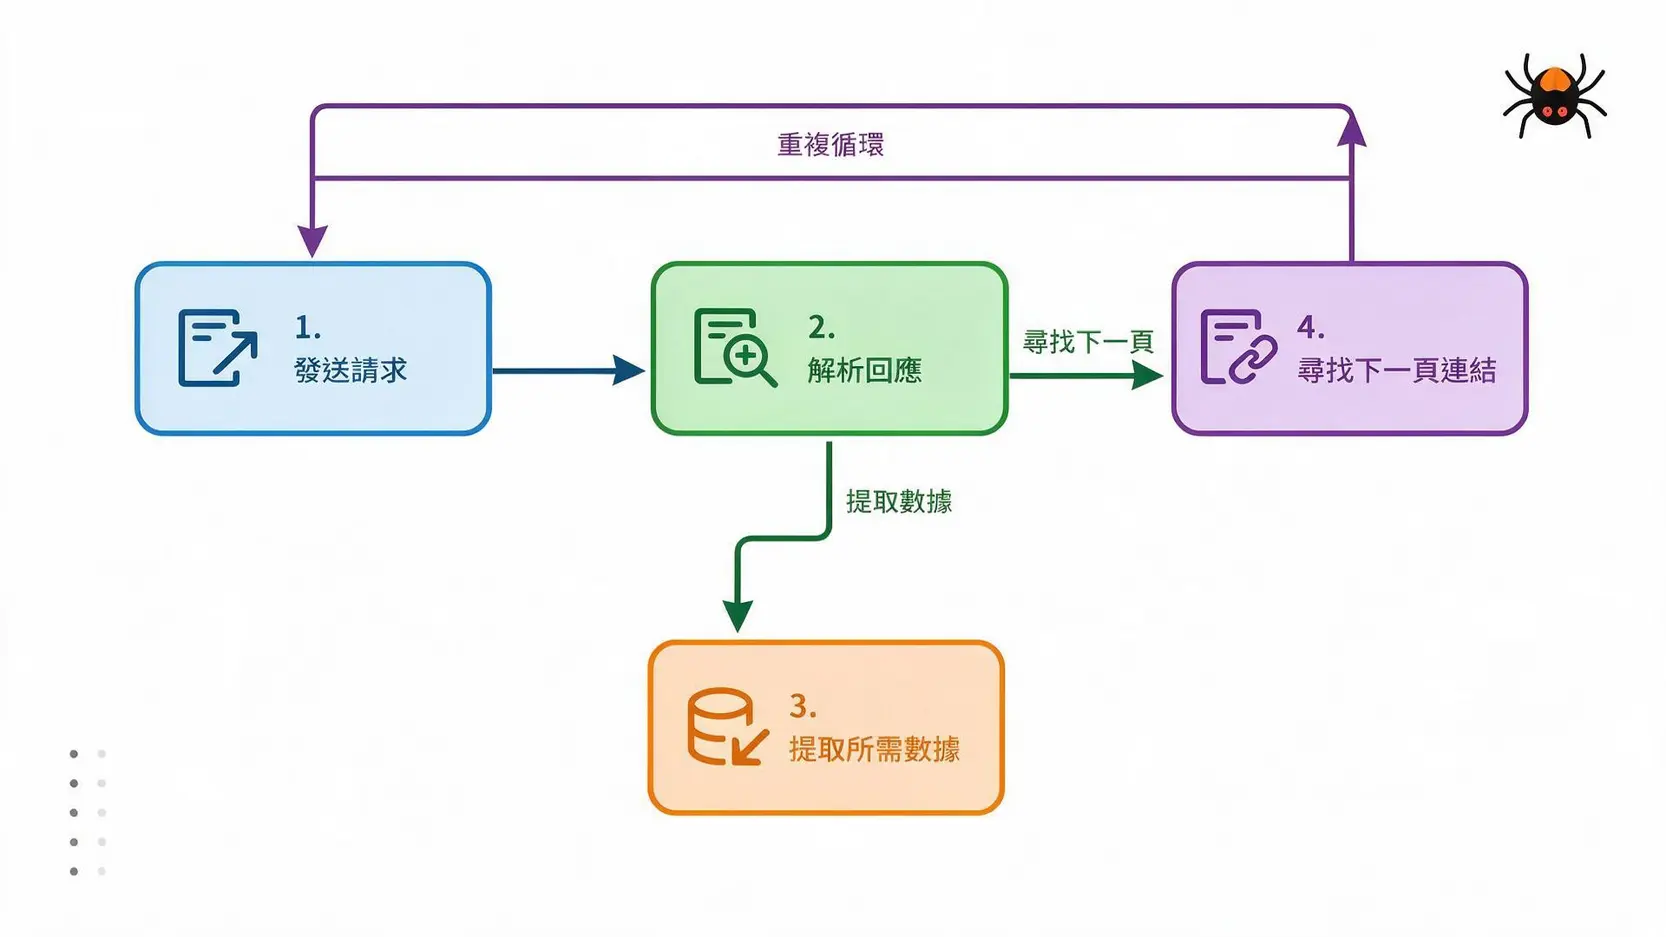
完整 Python 程式碼範例
以下是使用 Scrapy 抓取 PTT 八卦版文章的完整程式碼範例。請注意,在執行此爬蟲前,你需要確保已經安裝了 Scrapy 函式庫,並且在 PTT 網站上處理了「我已滿18歲」的確認頁面。
常見問題與注意事項
在進行網路爬蟲時,有幾個重要的道德和法律問題需要注意,這邊提供表格給予比較
這個表格統整了在進行網路爬蟲時,從技術、法律到道德層面需要考慮的關鍵事項,幫助開發者建立一個健康且可持續的爬蟲專案。
| 面向 | 考量事項 | 說明 |
|---|---|---|
| 技術層面 | 遵守 robots.txt |
這是網站擁有者告知爬蟲哪些頁面可以或不可以抓取的協議。雖然不是強制性,但遵守它是基本的網路禮儀。 |
| 技術層面 | 設定請求延遲 (Request Delay) | 避免在短時間內對目標網站發動大量請求,以免造成對方伺服器過載。一個合理的延遲(如1-3秒)是必要的。 |
| 技術層面 | 設定 User-Agent | 在請求的標頭 (Header) 中表明你的爬蟲身份,例如附上聯絡方式,讓網站管理員在必要時可以聯繫你。 |
| 法律層面 | 版權與智慧財產權 | 抓取下來的資料可能受到版權保護,未經授權的重製、散布或商業使用都可能觸法。 |
| 法律層面 | 個人資料保護法 | 如果抓取的資料包含個人資訊(如姓名、Email、電話),必須遵守相關的個資法規,不得濫用。 |
| 道德層面 | 不影響網站正常運作 | 你的爬蟲行為不應該對目標網站的服務品質造成負面影響。 |
| 道德層面 | 抓取目的正當性 | 思考你的爬蟲目的是否正當。是為了學術研究、市場分析,還是用於惡意競爭或非法活動? |
總結
Python 網路爬蟲是一個強大且充滿樂趣的技術領域。從本文的介紹與 Scrapy 實戰範例中,你可以看到,只要掌握了基本原理和工具,就能夠自動化地從網路上獲取寶貴的資料。然而,能力越大,責任也越大。在享受爬蟲帶來便利的同時,務必遵守相關的法律規範與網路禮儀,做一個負責任的開發者。